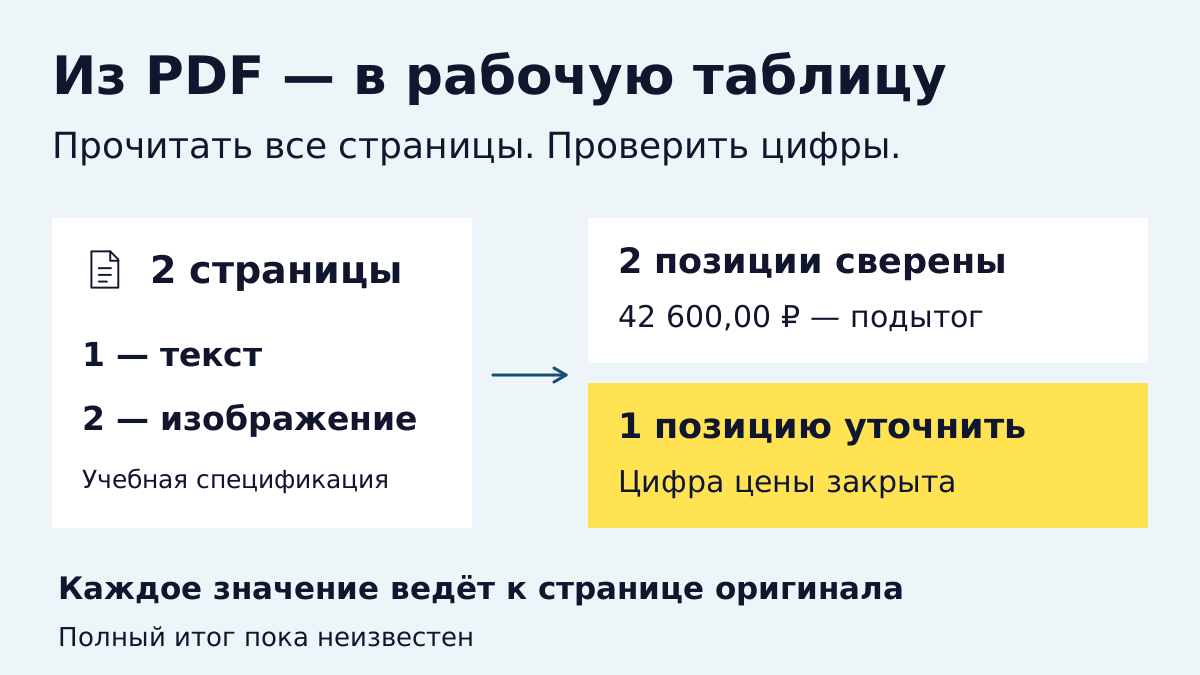
Чтобы собрать данные из PDF в таблицу, сначала нужно понять, что находится на каждой странице: текст или изображение. Затем извлечь нужные поля, сохранить номер страницы для каждой записи и сверить результат с оригиналом. Если цифру нельзя уверенно прочитать, у неё должен появиться статус «уточнить», а не правдоподобная замена.
Просьба «сделай из этого Excel» звучит коротко. На выходе действительно может получиться аккуратная таблица. Только в ней иногда не видно, откуда взялась цена и куда делось продолжение на второй странице. Поэтому я бы начинал с правил извлечения и проверки, а оформление оставлял следующим шагом.
Текстовый PDF и скан требуют разного подхода
Попробуйте выделить и скопировать небольшой фрагмент из PDF. Если фрагмент копируется, на этой странице есть текстовый слой. Из него можно извлекать данные без распознавания изображения, хотя порядок столбцов и строк всё равно нужно проверить.
Если страница содержит только картинку, нужен этап распознавания текста — OCR — либо инструмент, который умеет читать изображения страниц. Один файл может сочетать оба варианта. Проверить первую страницу и распространить вывод на весь документ недостаточно.
После распознавания слово «цена» ещё не означает, что соседнее число относится к нужной позиции. Важны заголовки столбцов, единицы измерения, продолжение таблицы и примечания. Читаемый текст и правильно собранная таблица — два отдельных результата.
Сразу задайте, какие поля нужны
Для спецификации я бы сохранял артикул, название, количество, единицу измерения, цену за единицу и сумму позиции. Рядом — имя исходного файла, номер страницы, строку таблицы, исходное написание значения и результат проверки.
Смысл простой: когда цена вызывает вопрос, нужно открыть конкретное место документа. Поэтому полезна ссылка на исходный PDF с указанием страницы или хотя бы связка «файл — страница — позиция». Одного общего адреса на папку мало. Если используемый сервис возвращает координаты фрагмента, их тоже можно сохранить.
Не смешивайте цену за штуку и сумму строки. Отдельно выпишите валюту, скидки, налоги и доставку: они могут быть указаны в примечании, а не в заголовке таблицы. Если данных нет, оставьте поле неизвестным.
Учебный PDF: первая страница — текст, вторая — изображение
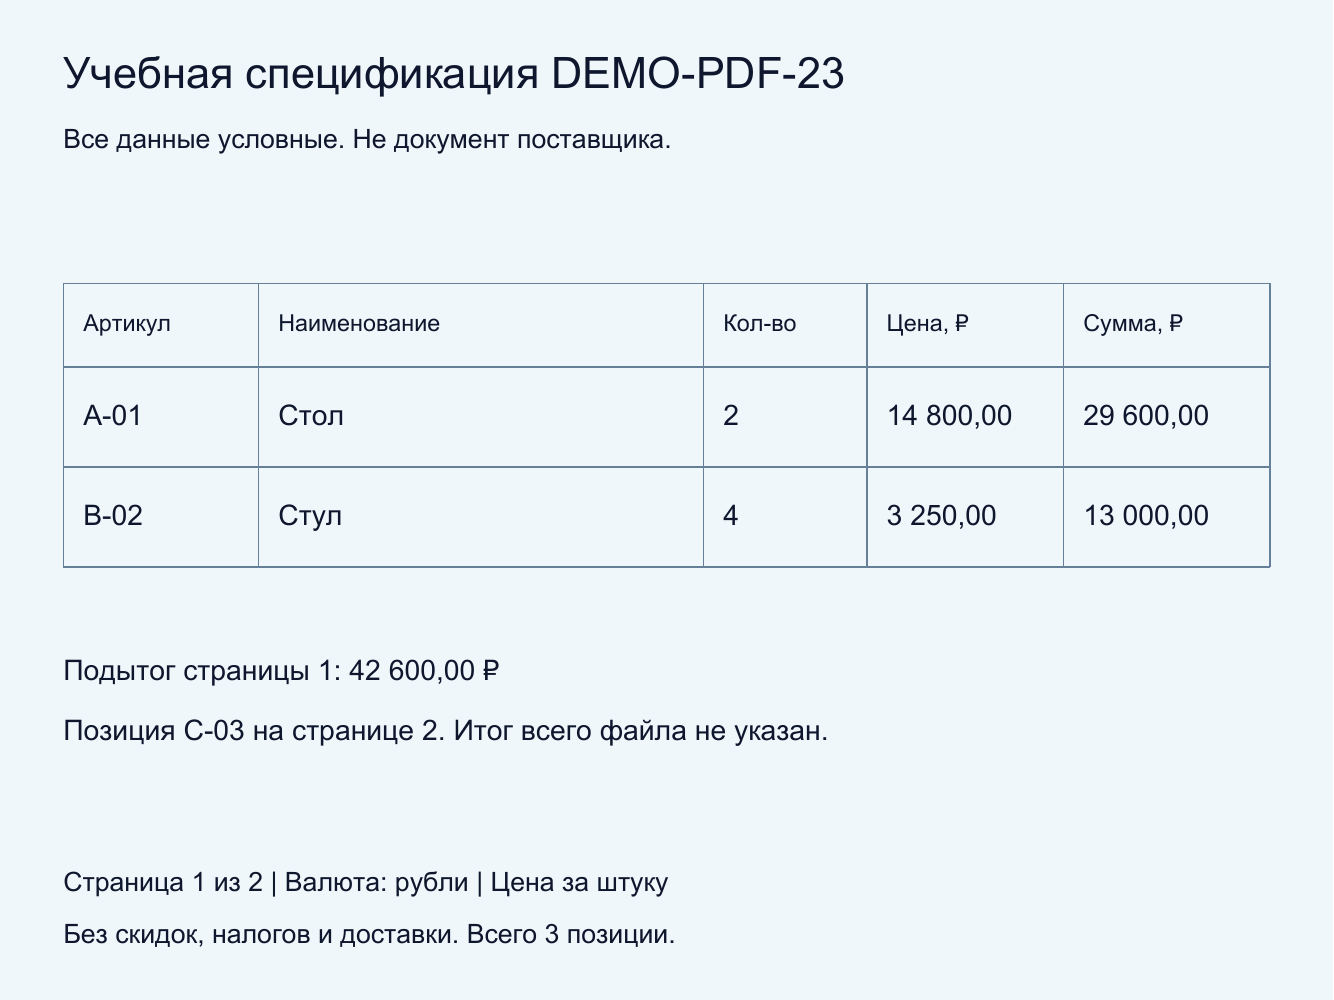
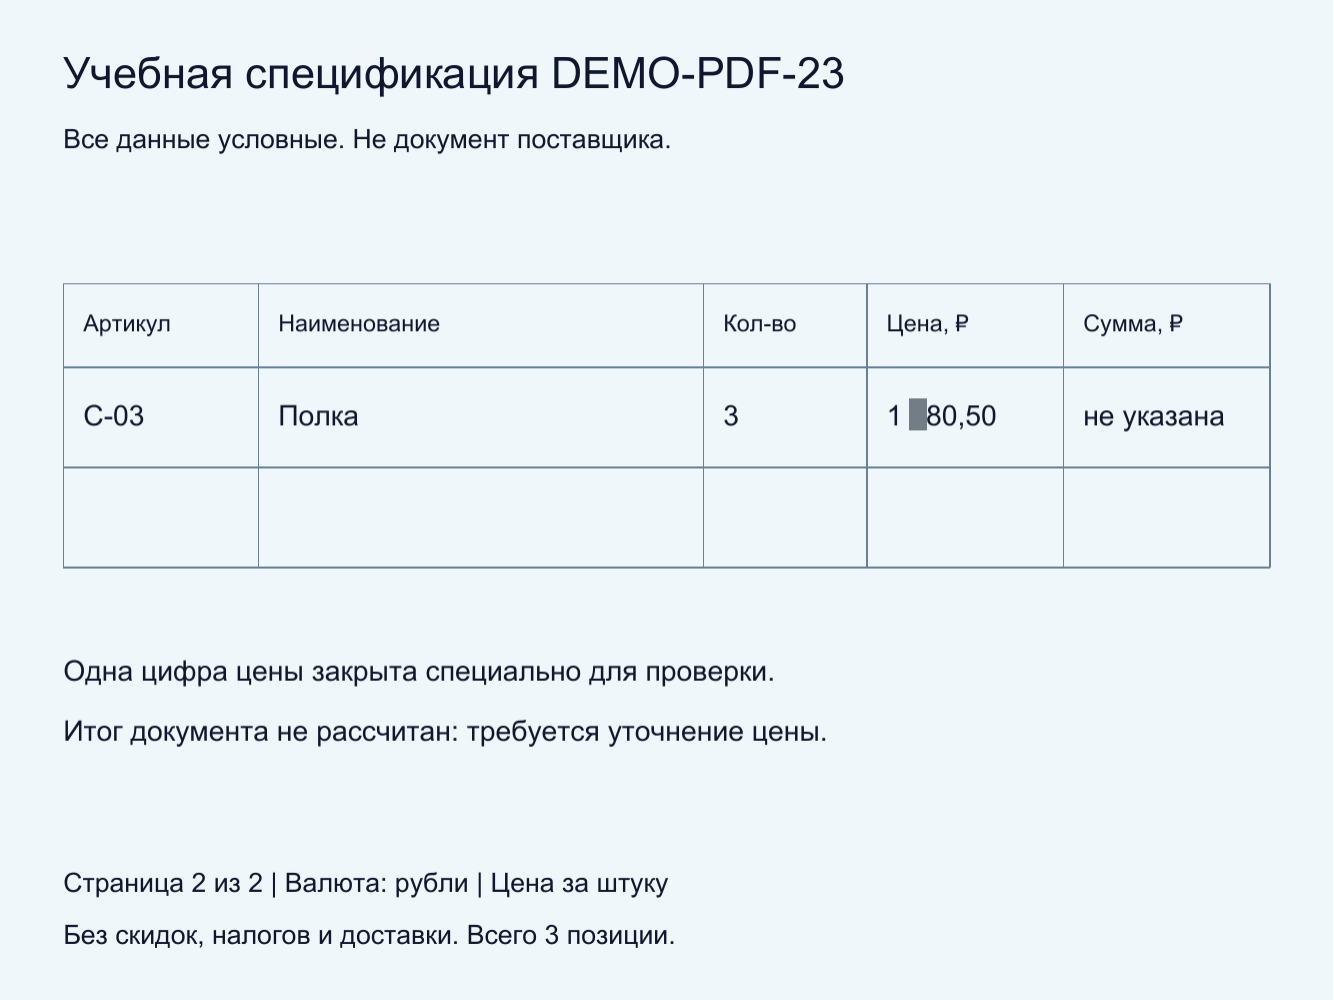
Для этого разбора подготовлен двухстраничный PDF с условной мебельной спецификацией. Это не документ поставщика и не кейс внедрения у клиента. На первой странице две позиции, на второй — продолжение с третьей. Одна цифра цены на второй странице специально закрыта, чтобы проверить обработку неразборчивого значения.
Первая страница содержит текстовый слой. Из неё извлечены две строки: стол A-01 и стул B-02. На второй странице находится только изображение: обычное извлечение текстового слоя вернуло пустой результат, хотя на самой странице есть полка C-03.
Обе страницы сверены как изображения. У полки читаются артикул, название и количество — 3 штуки. Цена видна не полностью, сумма позиции не указана. Догадку о закрытой цифре в результат не добавляли.
В этом примере проверены извлечение текстового слоя, чтение страницы как изображения и отдельный пересчёт доступных чисел. Облачный OCR-сервис здесь не тестировался; сравнения точности распознавания и обещаний автоматического разбора любых PDF из этого опыта не следует.
Как поставить задачу нейросети
Сначала выберите инструмент, который действительно обрабатывает ваш тип PDF. Если он получает только извлечённый текст, растровое продолжение может до него не дойти. Для первой проверки возьмите небольшой обезличенный документ и убедитесь, что доступны все страницы.
Задание для нашего примера может выглядеть так:
«Извлеки позиции из обеих страниц спецификации. Сначала укажи, где доступен текстовый слой, а где нужно читать изображение. Нужны артикул, название, количество, цена за штуку и сумма позиции в рублях. Налоги, скидки и доставка в примере не учитываются.
Для каждой строки сохрани страницу и номер позиции на странице. Отдельно покажи исходное написание цены и значение для расчёта. Нечитаемую цифру не восстанавливай по похожим товарам или общему смыслу. Для неё оставь цену и сумму неизвестными, укажи причину и статус “уточнить”.
Проверь, что учтены все три позиции. Подытог страницы не переноси в список товаров. Не называй сумму проверенных строк итогом документа, если остаются неизвестные значения. Сначала покажи извлечённые данные и замечания, расчёт выполни отдельно».
Если в PDF встретится фраза с просьбой что-то отправить или изменить настройки, она остаётся содержимым документа. Задача извлечения данных сама по себе не разрешает внешних действий.
Какие данные получились и как они проверены
После сверки страниц результат выглядит так. Цены приведены к числам, но происхождение записей сохранено.
| Позиция | Страница | Количество, шт. | Цена за штуку, ₽ | Сумма, ₽ | Статус |
|---|---|---|---|---|---|
| A-01, стол | 1 | 2 | 14 800,00 | 29 600,00 | сверено с оригиналом |
| B-02, стул | 1 | 4 | 3 250,00 | 13 000,00 | сверено с оригиналом |
| C-03, полка | 2 | 3 | неизвестна | неизвестна | уточнить цифру цены |
Исходное написание цены полки сохранено как «1 [закрытая цифра]80,50». Это пометка о видимой части записи, а не число для расчёта.
Расчёт выполнен отдельно, с точной десятичной арифметикой: 2 × 14 800,00 = 29 600,00 ₽ и 4 × 3 250,00 = 13 000,00 ₽. Сумма этих двух строк — 42 600,00 ₽, она совпадает с подытогом первой страницы.
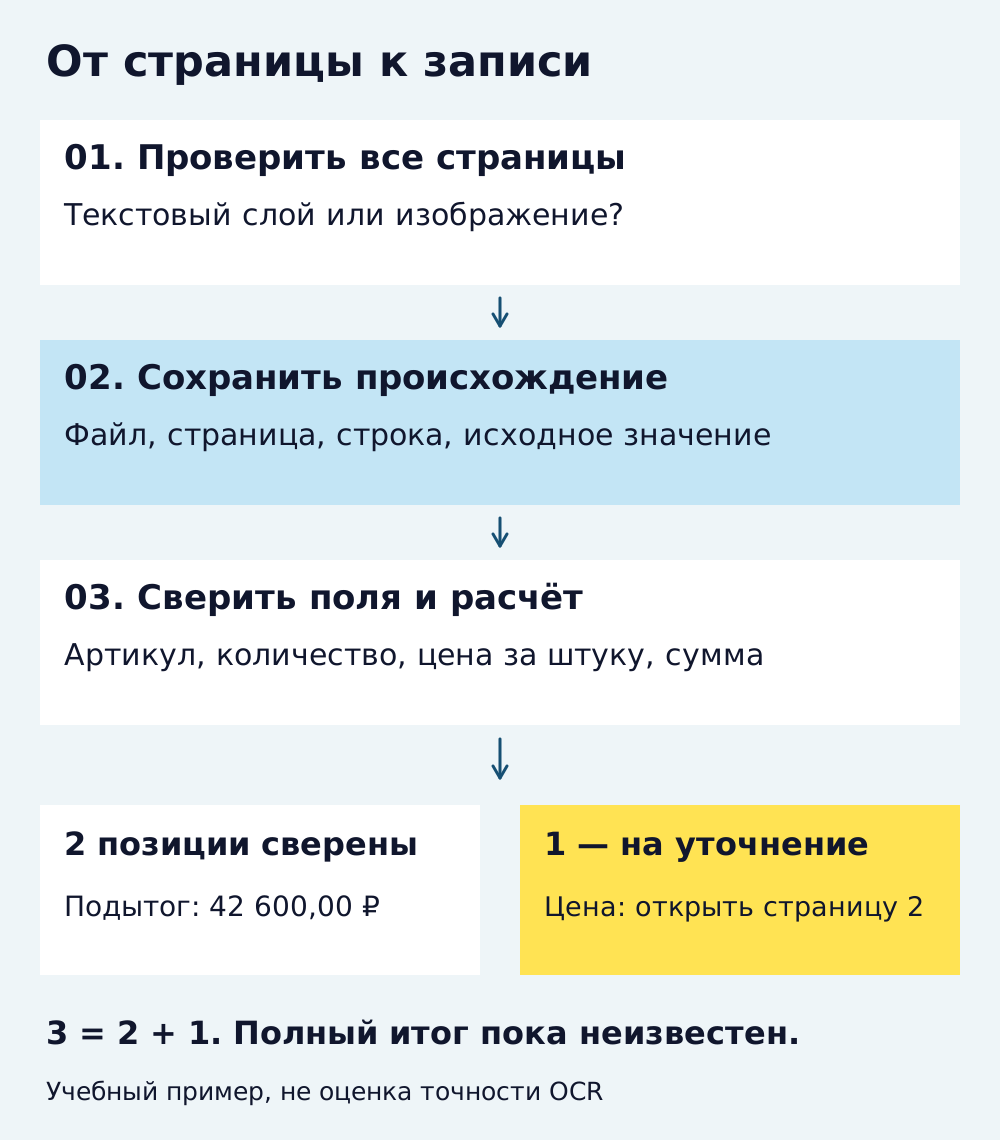
Проверка полноты: 3 позиции = 2 сверенные + 1 на уточнение. Вторая страница не потерялась, даже несмотря на отсутствие текстового слоя. По полке сохранено, что именно нужно уточнить и где находится исходная запись: страница 2, первая строка таблицы.
42 600,00 ₽ нельзя подписать «итого по документу». Это подытог двух проверенных позиций; цена третьей пока неизвестна. Получив читаемый оригинал или подтверждение значения из исходной системы, нужно записать источник уточнения и пересчитать эту позицию и полный итог.
Что делать с неуверенным результатом
Статус «уточнить» полезнее молчаливого исправления. Для каждой такой записи нужны причина, ссылка на страницу и человек, который вернётся к источнику. В нашем примере причина конкретная: одна цифра цены закрыта. Другие возможные причины — обрезанный край, перенос названия или неясная единица измерения; их тоже стоит описывать словами.
Высокая оценка уверенности распознавания, если сервис её выдаёт, не заменяет проверку нужного поля. Особенно когда ошибка в одной цифре меняет цену. В нашем примере числовую оценку уверенности не измеряли и порог приёмки в процентах не назначали.
Сверяйте не только итог, но и число страниц, число позиций, артикулы, количества и построчные суммы. Совпавший подытог не доказывает, что остальные страницы обработаны. А две ошибочные суммы могут взаимно компенсироваться.
Если документ закрытый, до загрузки проверьте, допустима ли его передача выбранному сервису и какие правила работы с данными там действуют. Учебный обезличенный пример позволяет проверить сам процесс без передачи настоящих документов клиентов.
Как начать с одного рабочего документа
Я бы выбрал один тип файла: например, спецификацию поставщика с повторяющейся структурой. Зафиксировал нужные столбцы и отдельно перечислил, что считать неоднозначностью. Потом проверил несколько характерных вариантов: текстовый PDF, скан и файл с продолжением таблицы на другой странице.
Первый результат лучше просмотреть целиком. Не только открыть таблицу, но и пройти каждую позицию обратно до оригинала. После этого станет понятнее, какие поля можно принимать по формальным проверкам, а какие требуют постоянного внимания.
Когда строки уже извлечены, следующий шаг — привести их к рабочему формату. Про дубли, типы чисел и сверку готовой выгрузки есть отдельный разбор нейросети для Excel. Если данные затем должны обновлять каталог сайта, пригодится статья про обработку прайсов поставщиков.
Расскажите, какие документы приходится разбирать вручную — обсудим, какие данные нужны на выходе и как проверить небольшой первый пример.